
前面我們都在處理使用者變多的問題。今天討論資安層面,換一個角度提問:
「如果有人存心想搞垮這個系統,或是想從裡面偷走一些不該拿到的東西,他會從哪裡下手?」
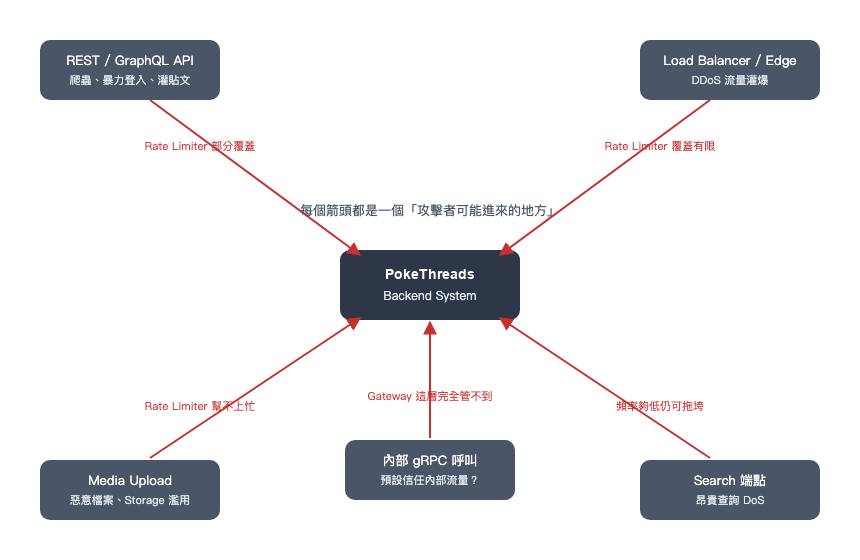
這種系統性盤點系統弱點的方法,叫做 Threat Modeling(威脅模型),核心做法很直接:把系統的每一個對外(甚至對內)的入口都列出來,一個一個討論「這裡可能出什麼問題,誰會想讓它出問題」。這些入口的集合,就是這個系統的 Attack Surface(攻擊面)。
值得先說清楚:今天不是要重新設計任何元件,而是用一雙攻擊者的眼睛,重新檢視我們這 27 天蓋出來的東西。
在動手盤點入口之前,先講清楚 Threat Modeling 實際上在做什麼。業界常見的做法,可以濃縮成四個問題:
今天的入口盤點,做的正是第 1、2 步;第 3 步具體該怎麼處理,會留到明天的 Security Architecture。
光說「可能出什麼問題」還是太抽象,業界很常用微軟提出的 STRIDE 框架,把威脅分成六大類,每一類都對應破壞了某一種安全特性:
| 分類 | 破壞的特性 | 白話說明 |
|---|---|---|
| Spoofing(偽冒) | Authenticity | 假冒成合法使用者或服務 |
| Tampering(竄改) | Integrity | 未經授權竄改資料 |
| Repudiation(否認) | Non-repudiation | 做了壞事卻讓系統查不出是誰做的 |
| Information Disclosure(資訊洩漏) | Confidentiality | 不該被看到的資料被看到了 |
| Denial of Service(阻斷服務) | Availability | 讓系統對正常使用者失去可用性 |
| Elevation of Privilege(權限提升) | Authorization | 從低權限帳號拿到不該有的高權限 |
有了這六個分類,等一下盤點每個入口時就不是憑感覺亂猜,而是可以逐一檢查,比較不容易漏掉。
另一個好用的概念是 Trust Boundary(信任邊界):系統裡任何一個「資料從一個信任等級,流向另一個信任等級」的地方,都算一道信任邊界,例如使用者輸入、跨服務呼叫、讀寫外部資料庫都算。
PokeThreads 目前最容易被忽略的信任邊界,藏在待會要談的入口五。
PokeThreads 的 REST/GraphQL API 是使用者互動最主要的管道,也是攻擊者最容易碰到的地方,常見的濫用手法:
GET /feed、GET /users/:id,把全站的公開資料一次性爬光用 STRIDE 來看,這裡同時橫跨好幾種威脅:Credential Stuffing 是 Spoofing(冒用合法身份登入)、爬蟲是 Information Disclosure(把不該被大量取得的資料整站爬走)、洗版則是 Denial of Service(癱瘓 Feed 的可用性)。
Day 15 的 Rate Limiter 有幫上忙嗎? 有,也沒有。
Rate Limiter 能有效擋住「同一個 IP / 同一個帳號短時間內狂打 API」這種粗暴攻擊,但如果攻擊者放慢速度、用大量不同 IP(例如 Botnet)分散打,每個來源看起來都「沒有超過限制」,Rate Limiter 就很難單靠速率本身抓出異常。這是今天要留給 Day 29 處理的第一個缺口。
PokeThreads 的入口本身也是攻擊目標。
有種攻擊手段叫做 DDoS(分散式阻斷服務攻擊),這種方法不是想偷資料,而是單純用大量流量把系統灌爆,讓正常使用者連不上服務。
Load Balancer 能把流量分散到多台 Server,一定程度上撐住流量,但如果攻擊流量的規模遠超過整個機房的頻寬上限,Load Balancer 本身也可能被打垮,這已經不是應用層的問題,而是需要更前面(例如 ISP 層級、專門的 Anti-DDoS 服務)的防護。Rate Limiter 在這裡幾乎幫不上忙:它工作在應用層,DDoS 流量往往連應用層的邏輯都還沒跑到,就已經把頻寬和連線數塞滿了。
STRIDE 分類上,這裡幾乎純粹是 Denial of Service,攻擊者沒有要偷資料、也沒有要冒充誰,單純就是要讓系統「不可用」,就好像請一堆黑衣人去實體店面排隊,排到了又不消費,真實的客人就進不了店。
還記得 Day 10 讓 Client 直接用 Pre-signed URL 上傳到 Object Storage 嗎?這裡藏著幾個風險:
這裡主要對應 STRIDE 的 Tampering(上傳偽裝過的惡意內容,竄改系統原本預期只會收到圖片/影片的假設)與部分 Denial of Service(濫用容量、灌爆帳單)。
Day 22 我們把搜尋交給了 Inverted Index,但搜尋本身也可能被拿來當攻擊武器。
構造特別複雜、涵蓋大量文件的查詢字串,即使頻率不高,單一 Request 就可能耗費大量運算資源,這是一種 Expensive Query DoS。攻擊者不需要靠「量」取勝,靠「單一 Request 的成本」就能拖垮系統。
這邊也顯現 Rate Limiter 的一個本質限制,它假設「每個 Request 的成本大致相等,所以限制次數就能限制總負擔」,但現實中不同 Request 的成本可能差非常多。
跟入口二一樣,這裡本質上也是 Denial of Service,只是換了一種手法:不用「量」取勝,改用「單一 Request 的成本」取勝。
前面四個入口都是「外部打進來」的,但 Day 13 拆出 Microservices 之後,Service 之間用 gRPC 互相呼叫,這其實也是一個攻擊面,只是很容易被忽略。
如果 Notification Service 預設「凡是走內部網路打過來的請求都可以信任」,一旦攻擊者透過任何方式滲透進內部網路(例如某個 Service 有其他漏洞),就能直接用內部身份呼叫其他服務,完全繞過 Day 14 API Gateway 那一層的所有防護,因為 Gateway 本來就只顧外部進來的流量,管不到內部服務之間怎麼互相信任。
這正是前面提到的 Trust Boundary 活生生的例子:「內部網路」常被當成一條隱形的信任邊界,資料一跨過這條線就被預設為可信,但邊界本身其實從來沒有被真的驗證過。
STRIDE 上,一旦攻擊者跨過這道邊界,威脅通常會同時牽涉 Spoofing(冒充成合法的內部服務)與 Elevation of Privilege(原本外部帳號拿不到的權限,透過內部呼叫拿到了)。
把今天走過的入口整理一下:
| 入口 | 主要威脅 | STRIDE | Rate Limiter 是否足夠 |
|---|---|---|---|
| REST/GraphQL API | 爬蟲、暴力登入、洗版 | S / I / D | 部分有效,分散式攻擊仍可繞過 |
| Load Balancer / Edge | DDoS | D | 幫助有限,需要更外層的防護 |
| Media Upload | 惡意檔案、Storage 濫用 | T / D | 無效,管不到檔案內容本身 |
| Search 端點 | 昂貴查詢 DoS | D | 無效,因假設每個 Request 成本相等 |
| 內部 gRPC | 內部信任被濫用 | S / E | 無效,完全在管轄範圍之外 |
看下來會發現一個共通的模式:Day 15 的 Rate Limiter 是很好的第一道防線,但它從來就不是萬能藥,它假設攻擊者行為單純(同一來源、固定頻率、成本均等),一旦攻擊者稍微聰明一點,或問題根本不在「頻率」上,就需要別的機制補上。
Threat Modeling 的「風險評估」步驟,概念上就是:
Risk = Impact(衝擊)× Likelihood(發生機率)
簡單來說,衝擊越大、越容易發生的威脅,越該優先處理。
用這個角度重新看這些入口:
這兩者明顯是優先順位最前面的,這也是明天 Security Architecture 會優先補上的部分;Search 的昂貴查詢與 Media Upload 的檔案風險,相對來說衝擊範圍較侷限,可以排在後面處理。
今天沒有畫任何新架構,只是換了一個視角,重新盤點這 27 天蓋出來的系統:每一個對外的入口,都是一個可能被利用的攻擊面。
今天用到的工具其實很簡單:
盤點下來,目前系統裡明確還缺的東西包括:
這些缺口,就是明天 Security Architecture 要補上的東西。


 iThome鐵人賽
 看影片追技術